Evals
Casos de teste mais critérios objetivos, rodados a cada mudança. Sem evals, todo ajuste de prompt é chute.
Em uma frase
O conjunto de casos de teste e critérios objetivos que mede a qualidade do sistema de IA, executado automaticamente a cada mudança.
Antes
Mudança no prompt, tool ou modelo
O que ele faz
Roda casos + critérios objetivos
Depois
Libera o deploy, ou barra
Analogia
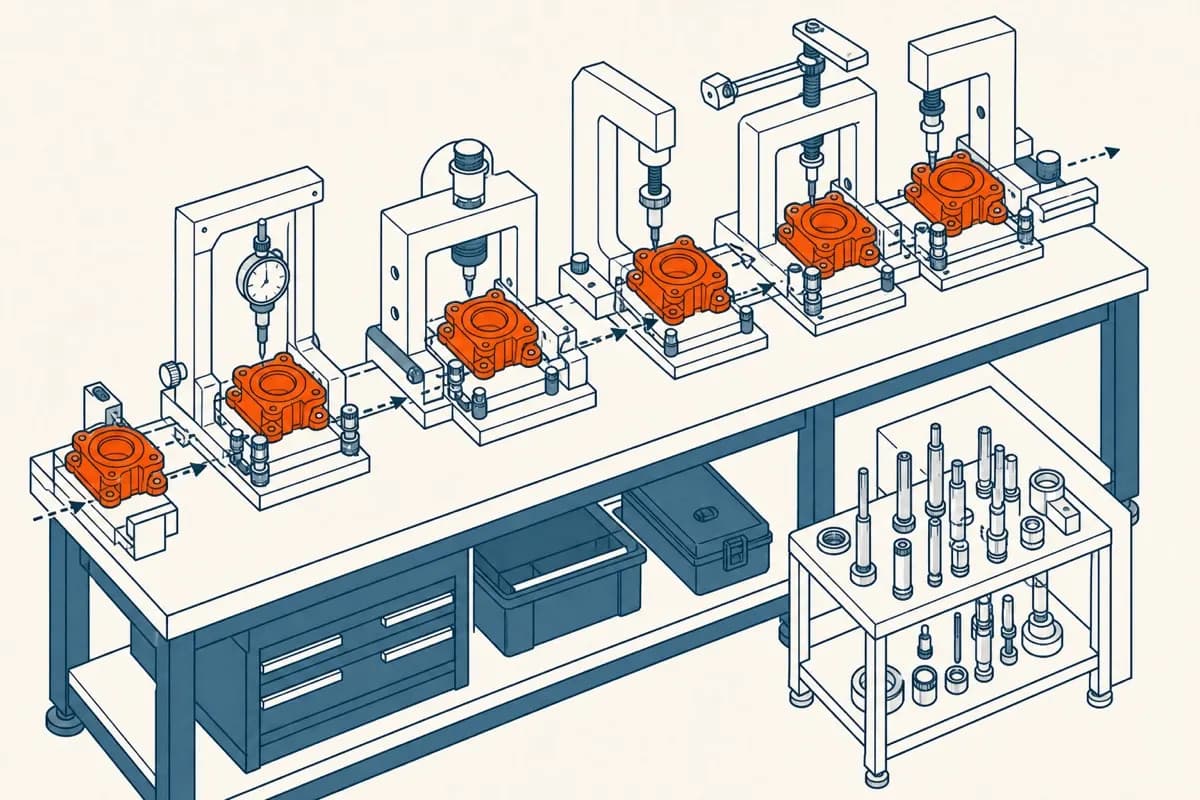
Pense no controle de qualidade da linha de produção. Ninguém pergunta "achei que ficou bom?" peça por peça; existe um gabarito e um teste que roda sempre igual.
Exemplo
A suíte roda as 200 cartas do golden dataset e mede cinco critérios:
- Fidelidade factual: toda afirmação tem fonte no relatório de campo (verificação automática)
- LGPD: nenhum dado proibido, como endereço, nome da escola ou sobrenome da criança
- Idioma: o do padrinho, que pode ser diferente do idioma do relatório
- Extensão: entre 180 e 320 palavras
- Tom e dignidade: avaliado por LLM-as-Judge
Cada alteração de prompt dispara a suíte inteira, que leva 6 minutos e custa R$ 4, menos do que uma reunião para discutir se ficou bom.
O erro comum
Achar que "testamos com uns 10 exemplos e ficou ótimo" é eval. Isso é impressão. Eval precisa ser reproduzível, versionada e rodada por inteiro a cada mudança.
O segundo erro é mais sutil: medir só o que é fácil de medir. Contagem de palavras entra na suíte, tom e fidelidade ficam no olhômetro, e o sistema melhora justamente naquilo que menos importa. Critério subjetivo também entra na suíte, avaliado por LLM-as-Judge.
Na prática
- Comece com 20 casos e 3 critérios. Uma suíte de 200 casos e 12 critérios tende a ficar sem rodar, e aí não mede nada.
- Um script, um comando, saída em tabela com percentual por critério.
- Versione a suíte junto com o prompt: eles mudam juntos.
- Falha na suíte bloqueia o deploy, como teste de software.
- Ferramentas típicas: Promptfoo, Langfuse ou 100 linhas de Python. O hábito de rodar pesa muito mais que a escolha da ferramenta.
Como tangibilizar
Um script que roda os casos do gabarito contra os critérios e imprime o percentual de cada um.
Nota
Satisfação (% de atingimento) é a versão informal disto: quanto o resultado entregue atingiu o desejado. Serve no começo, mas todo critério de satisfação que se repete duas vezes deve virar item da suíte. Do contrário, a avaliação continua dependendo de quem estava na sala.