Monitoramento (Traces)
Eval é antes, em laboratório. Monitoramento é depois, em produção. Você precisa dos dois.
Em uma frase
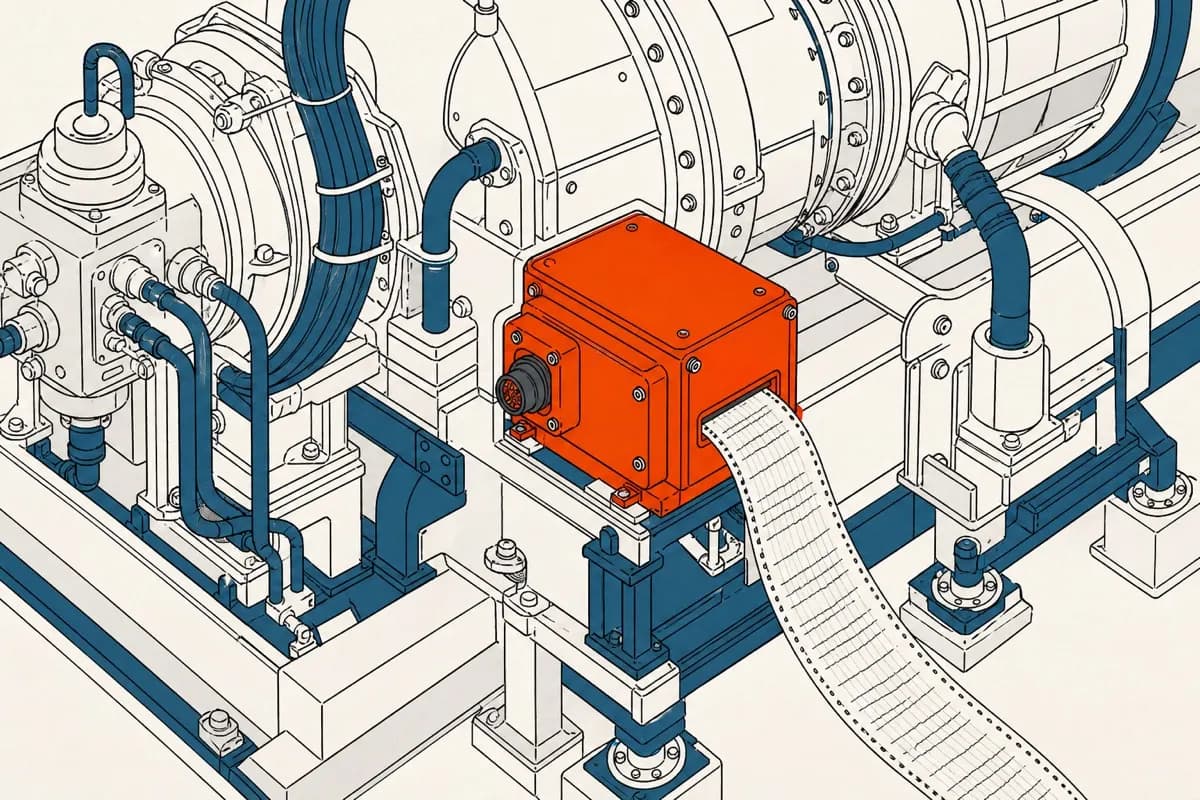
O registro do que o agente fez em cada etapa (prompts, chamadas de ferramenta, custo, latência, falhas) enquanto ele roda em produção.
Antes
Agente rodando em produção
O que ele faz
Registra prompt, tool, custo e latência
Depois
Anomalia visível antes do padrinho
Analogia
A caixa-preta do avião. Ela não impede o acidente, mas permite entender o que houve e evitar que se repita.
Exemplo
O painel mostra, por carta: custo (R$ 0,42), tempo (38s), quantas vezes o agente reescreveu durante a auto verificação e se escalou para humano.
Na terceira semana o custo médio saltou para R$ 1,10. O trace mostrou a causa em dois minutos: relatórios de campo digitalizados como imagem estavam entrando inteiros no contexto. Sem trace, a frase teria sido "a conta subiu e não sabemos por quê", e a resposta provável seria desligar o projeto.
O erro comum
Confundir eval com monitoramento. Eval acontece antes, em laboratório, com casos conhecidos e perguntas que você escolhe. Monitoramento acontece depois, em produção, com casos reais que trazem as próprias perguntas.
Quem só tem eval descobre o problema pelo padrinho. Quem só tem monitoramento descobre depois de já ter enviado. Os dois são necessários, e o que o monitoramento pega em produção deve virar caso no golden dataset.
Na prática
- Instrumente na primeira semana. Se o trace só começa depois do primeiro incidente, ele não ajuda a entender esse incidente.
- Registre por execução: entrada, saída, ferramentas chamadas, tokens, custo, latência e versão do prompt.
- Langfuse, LangSmith ou uma tabela no seu banco. O formato importa menos do que ter o registro.
- Três alertas simples pegam quase tudo: custo médio 2× acima da semana anterior, taxa de escalada subindo, latência p95 estourando.
Como tangibilizar
Registro por execução (entrada, saída, tools, custo, latência) mais três alertas simples.
Conecta com